우리의 초심
DeepSRT의 첫날부터의 원칙은 이렇다: 영상 하나 보려고 모델 리더보드를 공부하게 해서는 안 된다. 2025년 출시 때 우리는 그것을 더 철저히 했다 — API 키를 제공할 필요조차 없었고, Gemini 호출 비용은 전부 클라우드 뒤에서 우리가 부담했다. 단일하고, 신뢰할 수 있고, 설정 제로. 그것이 당시 「기본값」에 대한 우리의 전부였다. Gemini는 그 약속을 지탱해 왔고, 지금도 기본값이다.
하지만 2026년의 풍경은 달라졌다. 네이티브 앱은 키를 당신 손에 돌려줬고(BYOK), 우리는 open weights 모델들이 맹렬히 따라붙는 것을 지켜봤다. 무료 클라우드 모델, 믿기 어려울 만큼 싼 API, 심지어 당신의 Mac에서 도는 로컬 모델까지. 「신뢰할 수 있음」이 더 이상 희소하지 않다면, 한 가지 선택만 고집하는 것은 보호가 아니라 제한이 된다. 그래서 이번에는 모델의 선택권도 당신에게 넘긴다: 어떤 공급자, 어떤 모델 ID를 쓸지 당신이 정한다 — 예산 상한도 당신이 정한다.
다음 릴리스에서 DeepSRT는 모든 OpenAI 호환 엔드포인트를 지원한다. OpenCode Zen, OpenRouter, DeepSeek은 원탭 프리셋으로, Ollama나 LM Studio는 URL 하나로. 자막과 요약은 각자 따로 고른다 — 자막은 싼 모델로, 요약은 플래그십으로.
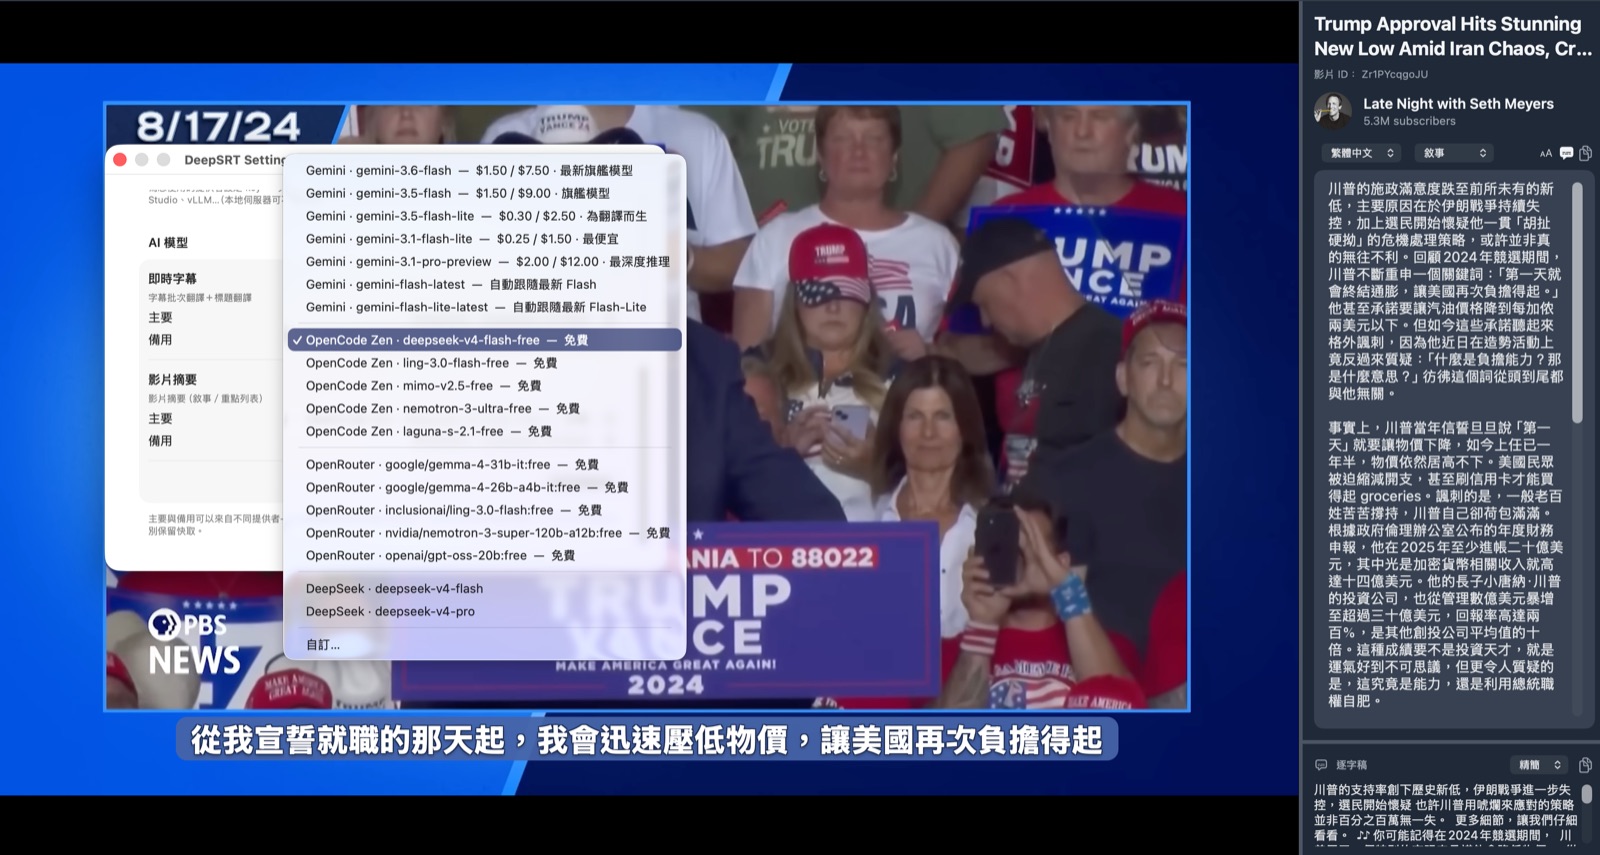
평가 기준: 속도와 가격 — 그러나 두 작업은 정반대를 원한다
선택을 열기 전에, 고르는 법부터 우리 스스로 정밀해져야 했다. DeepSRT의 두 AI 작업은 요구가 거의 정반대다.
실시간 자막은 추격전이다 — 3분 지점을 보고 있다면 그 구간의 번역은 몇 초 안에 도착해야 한다. 고빈도의 기계적인 작업: 40분 영상이 20줄씩 십여 개의 배치가 된다. 여기서는 지연이 전부이고, 품질은 「충분히 좋음」이면 된다.
요약은 영상당 한 번뿐이고, 좋은 요약을 위해서라면 10초쯤 기꺼이 기다린다. 여기서는 품질이 전부이고, 지연은 거의 느껴지지 않는다.
그러니 질문은 「어떤 모델이 최고인가」가 아니라 「어떤 모델을 어느 자리에 앉힐 것인가」였다.
Thinking: 지연 속에 숨은 세금
테스트 중 전형적인 함정에 빠졌다. 신세대 하이브리드 추론 모델은 기본적으로 생각한다. 23토큰짜리 한 문장을 번역하는데 모델은 먼저 151개의 추론 토큰을 태우며 인생을 고민했다 — 품질은 나아지지 않았고(번역에 철학은 필요 없다), 자막 배치의 지연은 몇 초에서 40초가 되었으며, 생각한 토큰은 전액 청구된다.
우리의 처리: 자막 배치는 항상 생각을 끈다(지연이 십분의 일로), 요약은 모델 기본값을 유지한다 — 영상의 서사를 이해하는 데라면 생각은 지불할 가치가 있는 비용이다. 이 판단은 내장되어 있다. 어떤 모델을 골라도 생각에 대해 생각할 필요가 없다.
실측: DeepSeek v4-flash vs Gemini Flash-Lite
자막 번역을 예로, 우리가 직접 측정한 숫자다(실제 20줄 배치):
| DeepSeek v4-flash | Gemini 3.5 Flash-Lite | |
|---|---|---|
| Input / 1M tokens | $0.14 | $0.30 |
| Output / 1M tokens | $0.28 | $2.50 |
| 20줄 배치 지연 | ~3.7s | ~1–2s |
| 40분 영상 한 편 | ≈ $0.009 | ≈ $0.05 |
자막 번역은 output 중심 작업이라 output의 9배 격차가 핵심이다: 환산하면 영상 한 편당 약 6배 저렴하다. 게다가 DeepSeek은 반복되는 프롬프트 접두사를 자동 캐시한다(배치마다 규칙 부분이 완전히 동일하다) — 캐시 적중 시 input은 거의 공짜다. 한편 Gemini Flash-Lite는 더 낮은 지연과 가장 안정적인 동작으로 앞선다 — 그래서 여전히 기본값이다.
그리고 새 아키텍처의 가장 좋은 부분: 둘 중 하나를 고를 필요가 없다. 기본과 폴백이 서로 다른 공급자여도 된다 — 자막 주력은 DeepSeek, 대기석에 Gemini. 서드파티가 제한을 걸거나 다운되는 순간 Gemini가 이어받아, 자막은 한 컷도 빠지지 않는다.
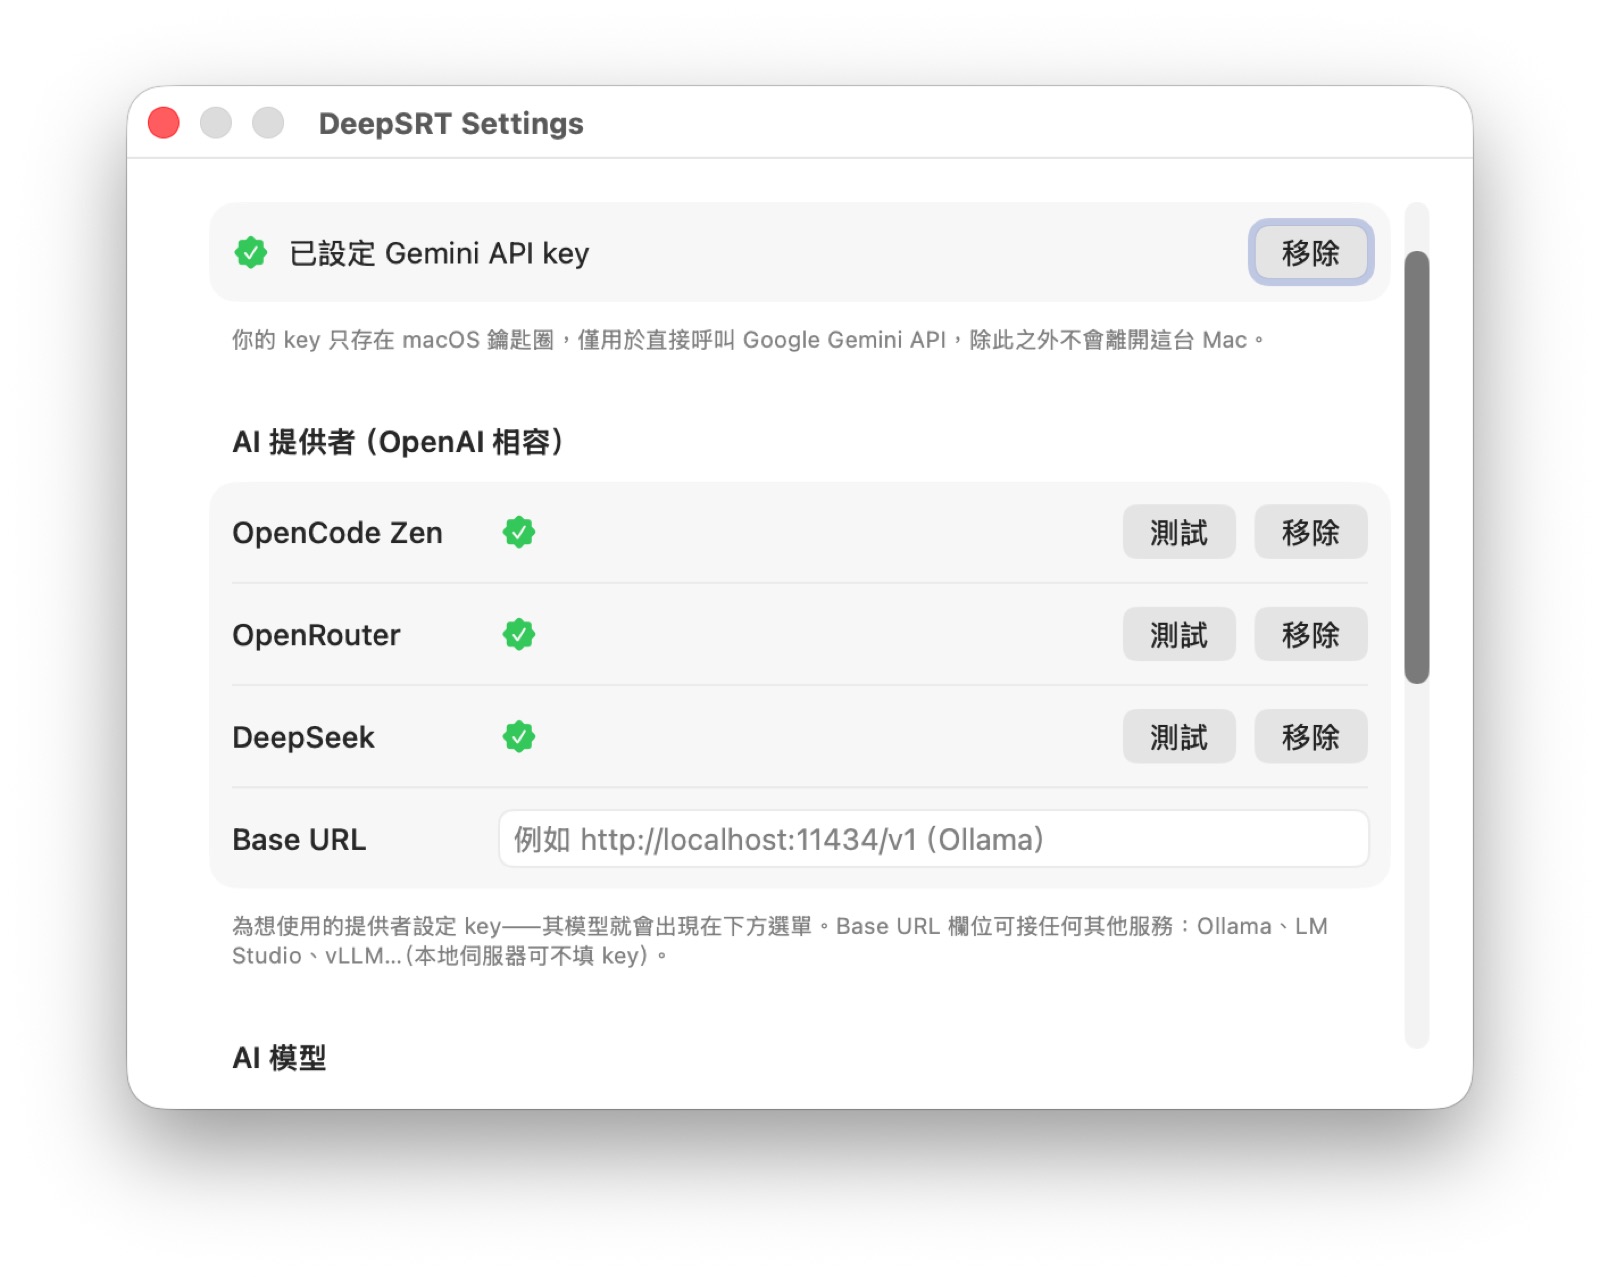
선택권
이렇게 물을 수도 있다: 이건 「리더보드 숙제」를 사용자에게 되돌려주는 것 아닌가? 아니다. 기본값은 여전히 우리가 조율한 Gemini 조합이고, 아무것도 건드리지 않으면 경험은 오늘과 똑같다.
하지만 아끼고 싶다면 — 무료 모델은 한 푼도 들지 않는다. 빠르고 싶다면 — Gemini에 머물러라. 프라이버시를 끝까지 밀고 싶다면 — Ollama는 모든 단어를 당신의 Mac에 남기고, 모델 공급사조차 볼 수 없다. 예산의 천장은 당신이 긋는다: 월 $0부터, 품질에 지불할 의향이 있는 어떤 숫자까지든.
DeepSRT는 서버가 없고, API 비용에서 수수료를 떼지 않으며, 이제 모델에도 묶이지 않는다. 우리가 파는 것은 어떤 모델의 입장권이 아니라, 이 모든 것을 조립하고 조율하고 계속 유지보수하는 그 손이다. 엔드포인트가 누구인지는 중요하지 않다. 선택권은 당신의 것 — 이것이 BYOK의 완성형이다.