我們的初衷
DeepSRT 從第一天起的原則就是:使用者不該為了看個影片研究模型排行榜。2025 年發布時我們做得更徹底——你甚至不需要提供 API key,Gemini 的每一筆費用都由我們在雲端背後替你吸收。單一、品質可靠、零設定,這是我們當時對「預設」的全部理解。Gemini 也確實撐起了這個承諾,直到今天它仍是預設。
但 2026 年的地景變了。Native app 把 key 交回了你手上(BYOK),我們也看著 open weights 模型一路追上來:有免費的雲端模型、有便宜到不可思議的 API、甚至有跑在你自己 Mac 上的本地模型。當「可靠」不再稀缺,堅持只給一種選擇就從保護變成了限制。所以這次,我們把模型的選擇權也下放給你:你決定用哪家 provider、哪個 model ID——你自己決定你的 budget cap。
下個版本,DeepSRT 支援任何 OpenAI 相容端點:OpenCode Zen、OpenRouter、DeepSeek 一鍵配置,Ollama、LM Studio 填個 URL 就接上。字幕和摘要可以各用各的——字幕跑便宜的,摘要留給旗艦。
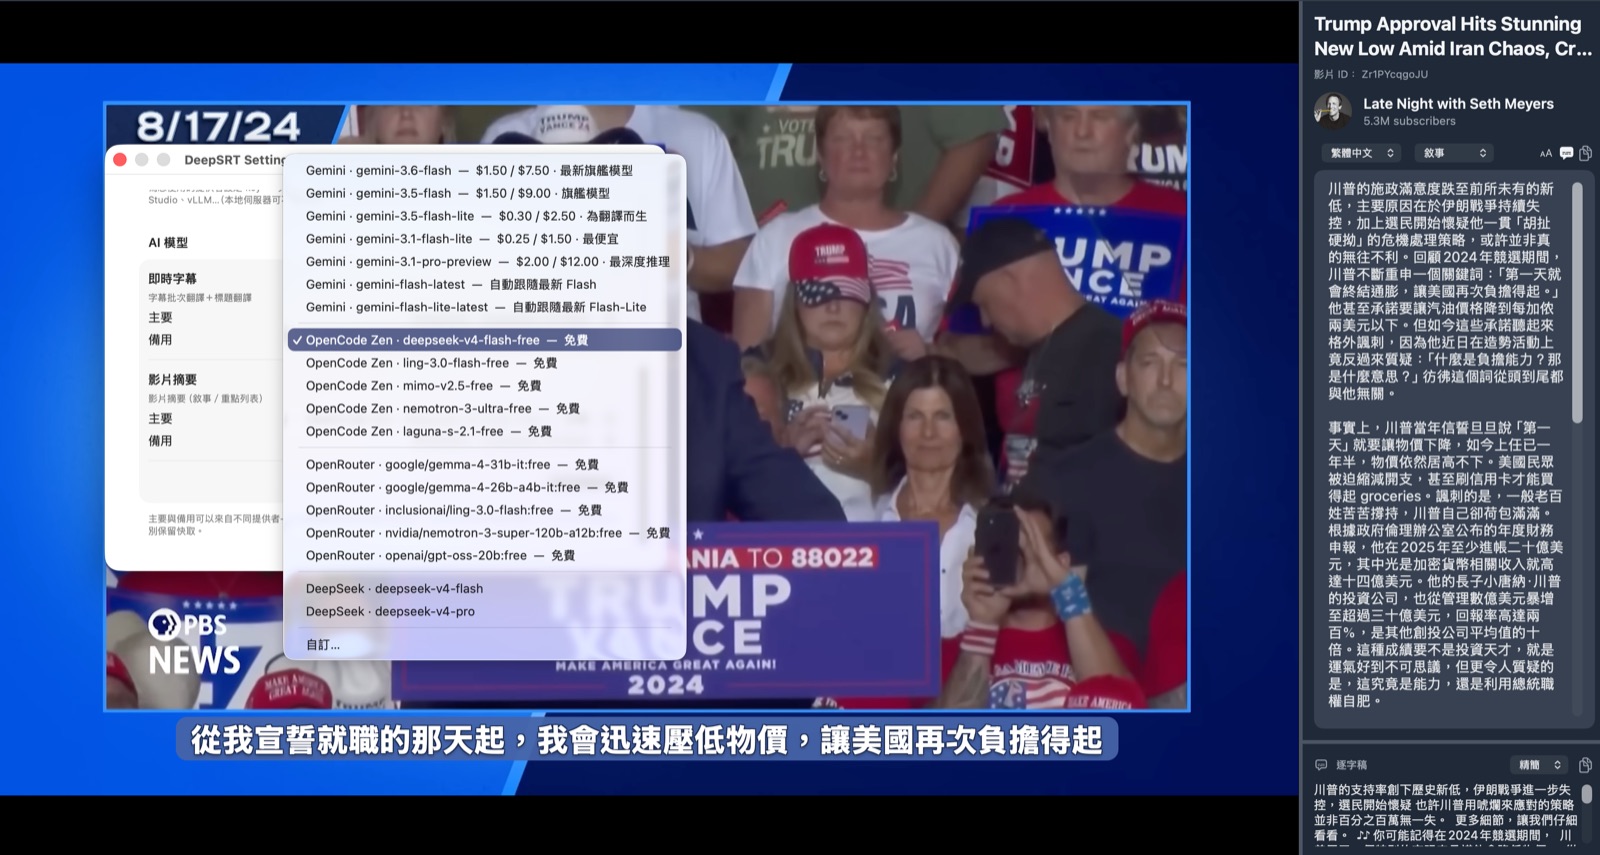
怎麼評估:速度和價格,但兩個任務要的不一樣
打開選擇的前提,是我們自己先搞清楚怎麼選。DeepSRT 有兩種 AI 任務,它們對模型的要求幾乎相反:
即時字幕是一場追逐——你在看 3 分鐘處,那一段的翻譯幾秒內就要到位。它是高頻、機械性的任務:一支 40 分鐘影片切成十幾批、每批 20 句。這裡延遲就是一切,品質「夠好」即可。
影片摘要一支影片只做一次,你願意等它十秒換一篇好摘要。這裡品質就是一切,延遲幾乎無感。
所以評估從來不是「哪個模型最好」,而是「哪個模型放在哪個位置」。
Thinking:藏在延遲裡的稅
測試中我們撞上一個典型陷阱:新一代 hybrid reasoning 模型預設開啟思考。翻譯一句 23 個 token 的話,模型先燒掉 151 個 reasoning token 思考人生——品質沒有變好(翻譯不需要哲學),但一批字幕的延遲從幾秒變成 40 秒,而且思考的 token 照價收費。
我們的處理:字幕批次一律關閉思考(延遲直接砍到原來的十分之一),摘要保留模型預設——理解一支影片的敘事,思考是值得付的成本。這個判斷已經內建,你選任何模型都不用自己操心。
實測:DeepSeek v4-flash vs Gemini Flash-Lite
以字幕翻譯為例,這是我們自己跑出來的數字(20 句一批的真實 batch):
| DeepSeek v4-flash | Gemini 3.5 Flash-Lite | |
|---|---|---|
| Input / 1M tokens | $0.14 | $0.30 |
| Output / 1M tokens | $0.28 | $2.50 |
| 20 句 batch 延遲 | ~3.7s | ~1–2s |
| 一支 40 分鐘影片 | ≈ $0.009 | ≈ $0.05 |
字幕翻譯是 output 為主的任務,所以 output 那 9 倍價差才是重點:換算下來一支影片約 6 倍便宜。DeepSeek 還會自動快取重複的 prompt 前綴(我們每批的規則段完全相同),命中時 input 幾乎免費。Gemini Flash-Lite 則勝在延遲更低、行為最穩——這就是為什麼它仍是預設。
而這正是新架構最好的部分:你不用二選一。主要模型和備用模型可以來自不同提供者——字幕主力跑 DeepSeek,備用掛 Gemini;第三方限流或掛掉的瞬間,Gemini 自動接手,你的字幕連一格都不會漏。
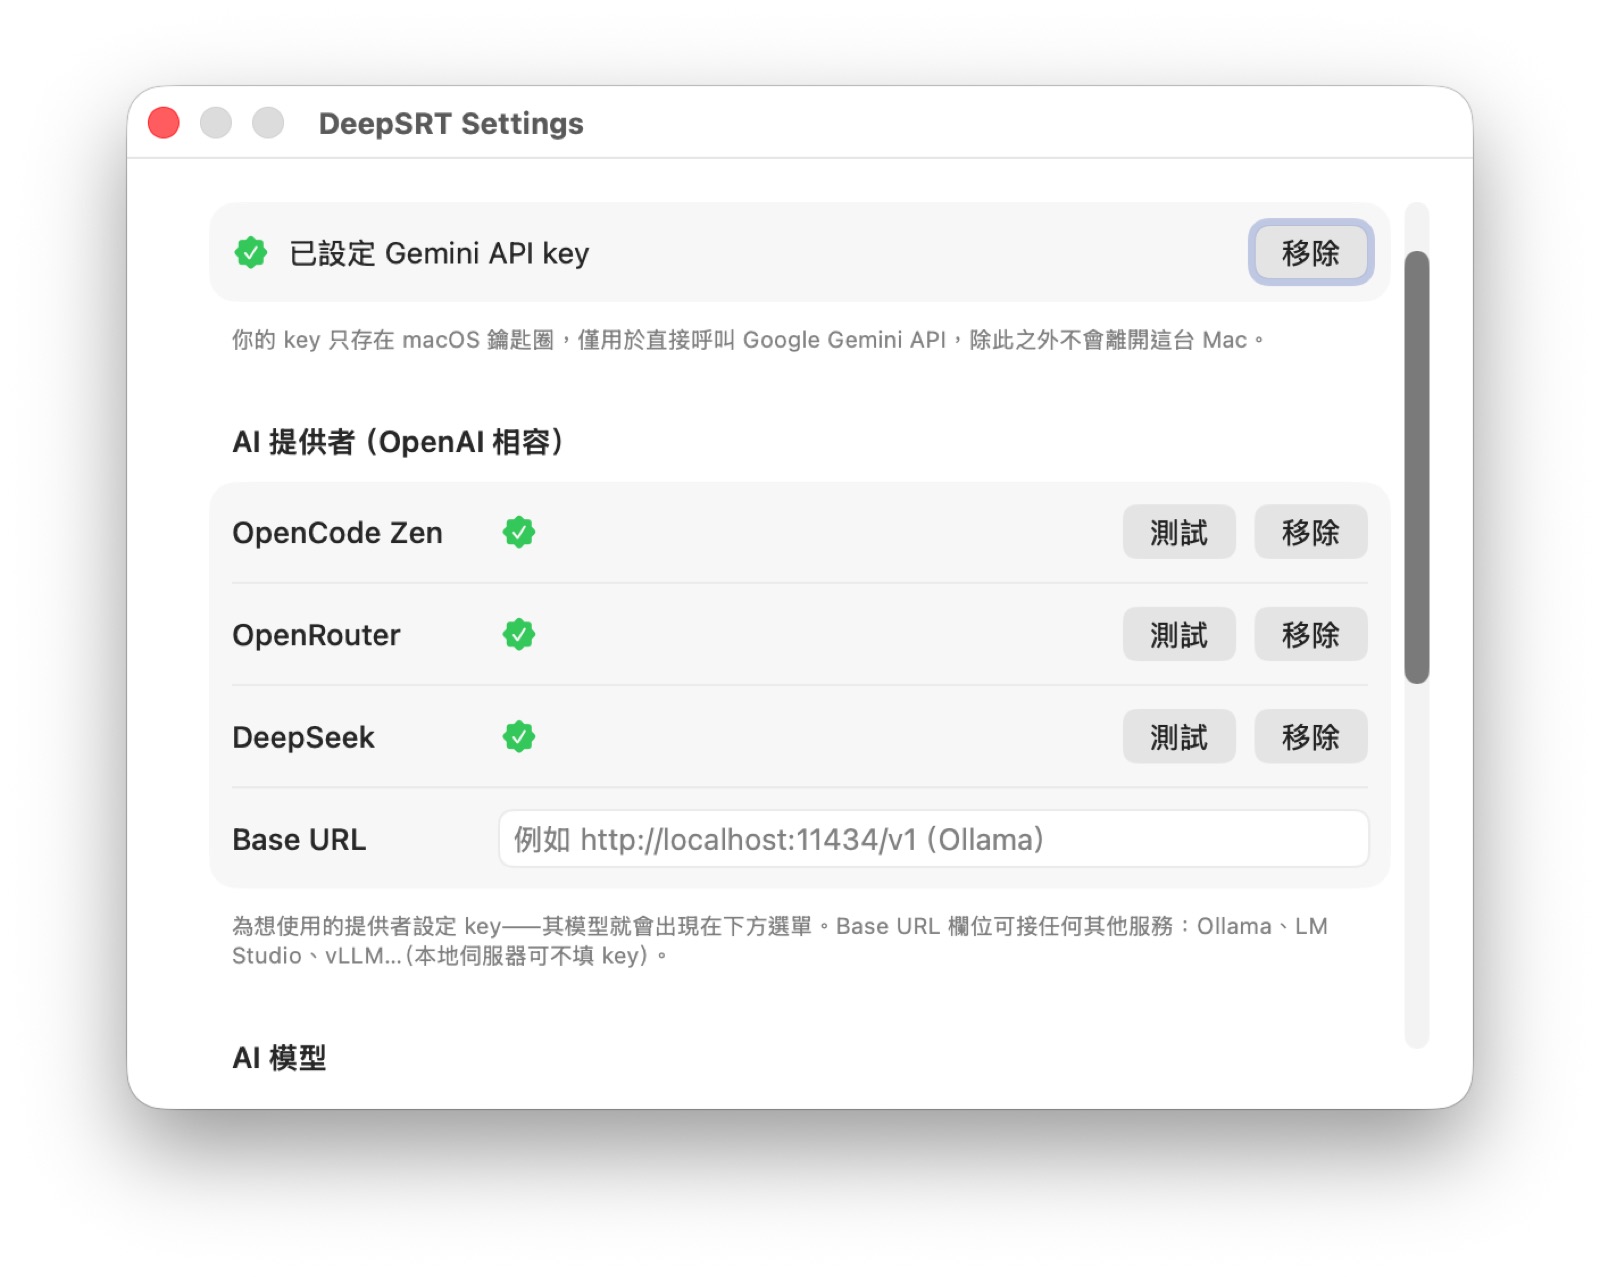
選擇權
有人會問:這不就是把「研究模型排行榜」的負擔還給使用者嗎?不是。預設依然是我們調校好的 Gemini 組合,你什麼都不動,體驗和今天一模一樣。
但如果你想省——免費模型一分錢不用花。如果你想快——留在 Gemini。如果你在乎隱私到極致——Ollama 讓每一個字都留在你的 Mac 上,連模型供應商都看不到。預算的天花板由你自己畫:從每月 $0 到你願意為品質付出的任何數字。
DeepSRT 沒有伺服器,不抽你的 API 費用,現在連模型都不綁定。我們賣的從來不是某個模型的門票,是把這一切組裝起來、調校到位、持續維護的那雙手。端點是誰不重要,選擇權是你的——這才是 BYOK 的完全體。