1.3.0이 출시된 그날 밤, 실제 영상들로 혹독하게 시험했습니다——금융 채널의 주말 리뷰, 여러 명이 대화하는 심령 팟캐스트, 말레이시아 심령 스팟 현장 실록. AI 전사는 1.3.0의 간판 기능입니다: 자막 트랙이 없는 영상이면 DeepSRT가 Gemini에게 영상을 직접 '보게' 하고, 라이브 자막·대본·요약이 그대로 작동합니다.
텍스트는 거의 매번 맞았습니다. 시간은, 거의 매번 제멋대로였습니다.
모델은 알아듣지만, 박자를 못 맞춘다
첫 영상은 정확히 60초짜리 자막 16개로 돌아왔습니다——1분치 대본이 벽처럼 화면에 쌓였습니다. 더 잘게 잘라 달라고 하자 고분고분 181개의 예쁜 자막을 줬는데, 타임라인이 줄곧 표류했습니다: 중반에 수십 초 늦고, 마지막 자막은 4,181초에 떨어졌습니다——영상 전체 길이는 858초입니다.
우리 프롬프트가 잘못된 게 아닙니다. 커뮤니티 전체가 기록해 온 Gemini의 한계입니다: SRT급 정밀 타임스탬프를 만들 수 없고, 세밀함과 정확함은 맞바꾸는 관계——잘게 자르라고 다그치면 표류로 값을 치릅니다.
공정하게 말하면 Google 공식 문서는 자막급 시간 정밀도를 약속한 적이 없습니다. 능력 목록에 적힌 것은 '묘사, 분할, 정보 추출, 특정 타임스탬프 참조'——타임스탬프를 참조하는 것과 밀리초 SRT를 만드는 것은 다른 일입니다. YouTube URL 입력 자체도 아직 preview(무료, 하루 8시간 한도, 규칙은 언제든 바뀔 수 있음)입니다. 공식적으로 preview라 적힌 지반 위에 시간 정밀도가 필요한 기능을 짓고 있는 셈——아래 표의 모든 프로젝트가 같은 벽 앞에서 방향을 튼 이유입니다.
| 공식 문서의 표현 | DeepSRT에 갖는 의미 | |
|---|---|---|
| Preview | “The YouTube URL feature is in preview and is available at no charge. Pricing and rate limits are likely to change.” | 우리의 preview 표기는 신중해서가 아니다——업스트림 자체가 아직 미확정 |
| 한도 | 무료 티어는 하루 YouTube 영상 8시간까지, 공개 영상만 | 일일 한도의 공식 출처 |
| 비용 | 영상은 1 FPS로 샘플링, 저해상도에서 약 100 토큰/초(기본 300) | 우리 실측은 약 91 토큰/초로 공식 수치와 일치——'요청마다 영상 전체를 다시 수집'하는 비용의 근거 |
| 능력 | 능력 목록: describe, segment, extract information, 특정 타임스탬프 참조 | 자막급 시간 정밀도는 약속된 적이 없다——타임스탬프 참조와 밀리초 SRT 생성은 다른 일 |
다른 프로젝트들은 어떻게 했나
고치기 전에 커뮤니티부터 조사했습니다. 이 벽에 부딪힌 건 우리만이 아니었고, 모든 프로젝트가 결국 어떤 형태로든 포기를 선택했습니다:
| 프로젝트 | 부딪힌 벽 | 내린 결정 |
|---|---|---|
| pyVideoTrans | Gemini는 SRT급 정밀 타임스탬프를 만들지 못함. 배치 작업에서는 형식을 잊고 멋대로 재분할하기도 | Gemini에게 시간을 묻지 않기로. 오디오를 내려받아 VAD로 밀리초 단위 분할, Gemini는 텍스트만 |
| yt-whisper 계열 | 정확한 타임라인이 필요 | 멀티모달 모델 경로를 포기. 오디오를 내려받아 통째로 Whisper에게 |
| video-intel | 청크 전사에서 타임스탬프가 청크 간 어긋나고, 시(時) 자리가 사라지고, 내용이 조용히 누락. 더 강한 모델로 바꾸니 오히려 악화 | 라이브급 정밀도를 포기. 번역·검색용 오프라인 전사에 집중, 분할·정규화·커버리지 검사로 다층 방어 |
| gemini-transcribe | 세밀한 타임스탬프를 신뢰할 수 없음 | 세밀함을 포기. '논리적으로 묶인 타임스탬프'를 표방——읽기용이지, 플레이어 동기화용이 아님 |
패턴이 보이시나요: 오디오를 얻을 수 있으면 VAD와 Whisper로 달아나고, 얻을 수 없으면 정밀한 시간을 포기했다. 우리는 두 길 다 막혀 있습니다——DeepSRT는 영상을 내려받지 않습니다. 제품의 약속이자 이 기능이 존재하는 전제입니다. 그런데 라이브 자막은 시간이 맞아야 합니다. 공개된 자료에 성공 사례가 없는 일을 시도하고 있는 겁니다.
우리의 결정: 앵커만 믿고, 스팬은 믿지 않는다
측정을 거듭하자 규칙이 드러났습니다: 모델이 '이 문장은 몇 분 몇 초에 시작한다'고 할 때는 대체로 믿을 만합니다. '얼마나 오래 이어졌는가'는 자주 지어냅니다.
얼마나 심하냐면, 33분짜리 영상에서 모델은 22자짜리 자막 하나가 2,723초에 걸쳐 있다고 주장했습니다. 다른 회차엔 '전편 빈틈없는 커버리지'라는 답을 줬는데——글자 수를 시간으로 나누면 초당 0.3자. 중국어 구어는 초당 3~6자입니다. 향이 타는 것보다 느리게 말하는 사람은 없습니다.
그래서 1.4.0 자막 엔진은 신뢰의 경계를 여기에 그었습니다:
- 앵커는 쓴다. 자막 시작점은 모델의 타임스탬프를 따른다——독립 표본 검증으로, 굵직한 답변의 앵커는 초 단위로 정확함을 확인했다.
- 스팬은 직접 계산한다. 너무 긴 자막은 문장부호에서 자르고 글자 수에 비례해 시간을 배치——보간 오차에는 상한이 있고(최대 자막 하나 범위), 모델이 스스로 자른 표류는 무한히 누적된다.
- 물리가 심판한다. 주장된 스팬이 불가능한 말 속도를 뜻하면 그 시간은 허구다.
구멍이 억측보다 낫다
가장 어려운 교훈은 그 심령 영상에서 왔습니다. 긴 B롤, 환경음, 띄엄띄엄한 대화——모델은 몇 분에 흩어진 발화를 자막 하나에 욱여넣었습니다. 그 텍스트를 앵커로 눌러 담으면 틀리고(6분 뒤에 나올 말이 화면에 뜸), 스팬 전체에 펼쳐도 틀립니다(모든 줄이 20초씩 눌러앉음). 둘 다 억측입니다.
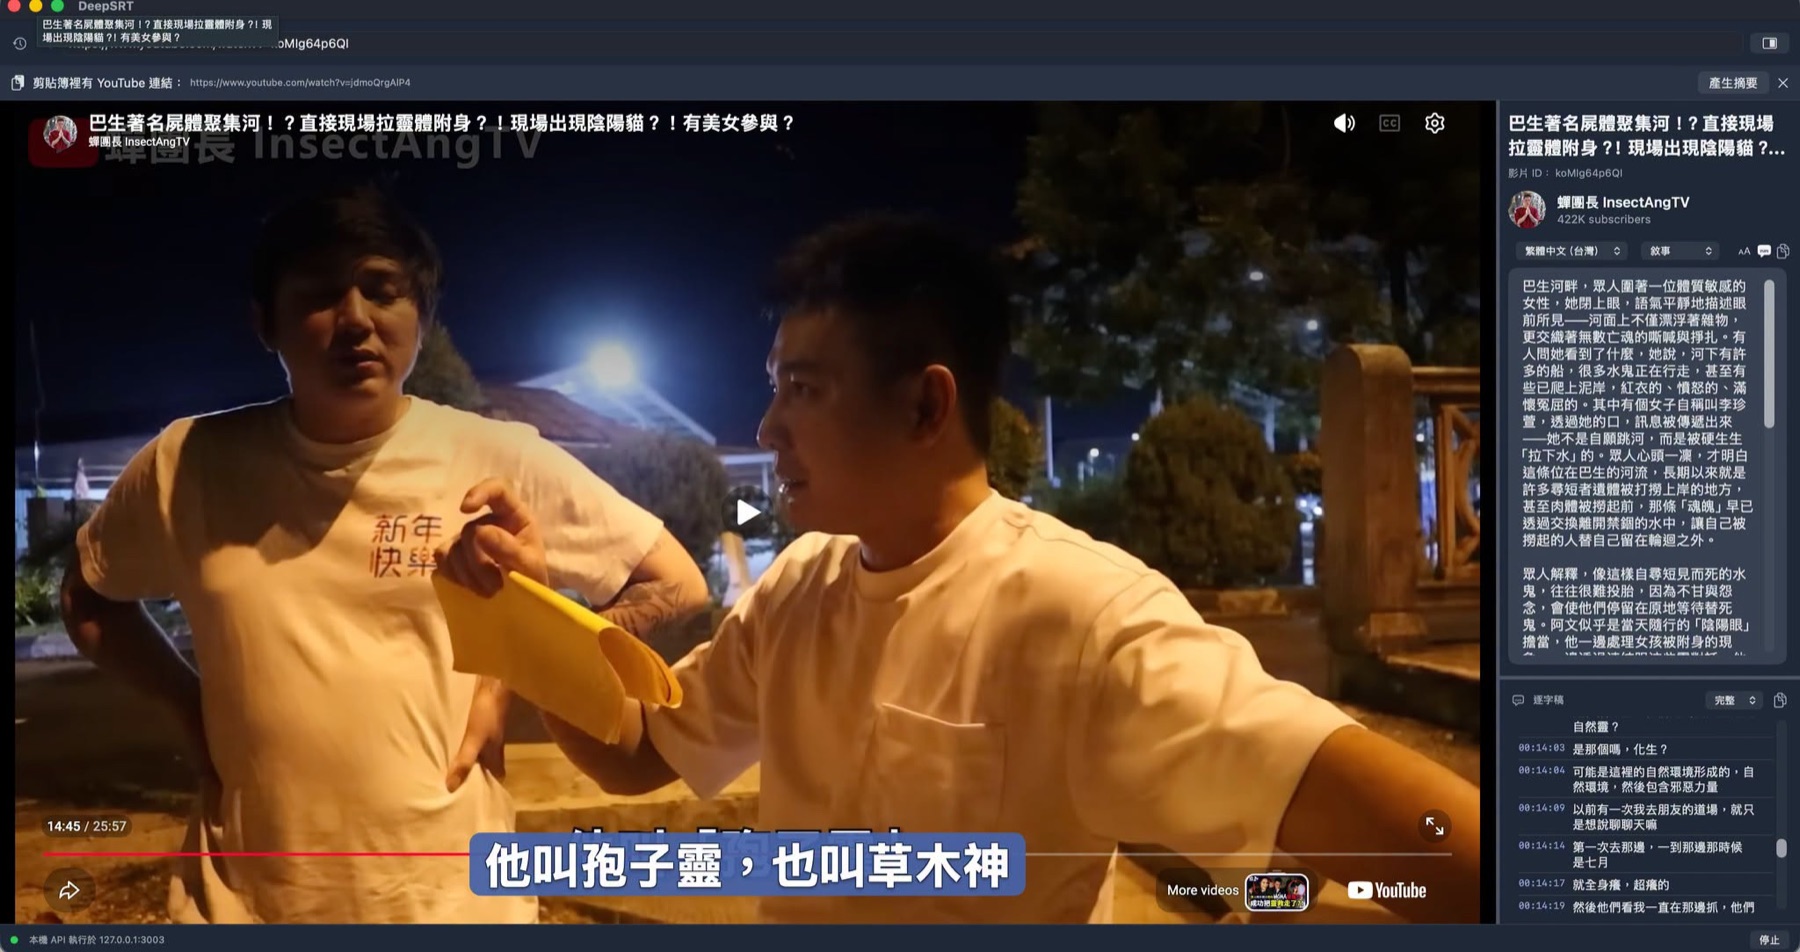
그래서 억측하지 않습니다: 욱여넣어진 자막은 버리고, 그 시간은 구멍으로 남깁니다. 엔진이 구간별로 커버리지를 감사하고, 빠진 범위만 다시 전사합니다——범위를 좁힌 질문에는 시간이 맞는 범위 답변이 돌아오기 마련입니다. 그래도 못 채우면 화면에 정직하게 알립니다: 이 몇 분은 전사할 수 없었다고.
비명, 군중, 음악뿐인 구간에는 애초에 전사할 말이 없습니다. 공백은 고장이 아닙니다——있는 척이 고장입니다.
솔직히: 아직 완벽하지 않습니다
위 표를 한 번 더 보세요——프로젝트마다 '정밀한 시간' 앞에서 방향을 튼 것은 노력이 부족해서가 아니라, URL만 있는 제약에서는 아직 완벽한 해법이 없기 때문입니다. 우리 방식으로 라이브 자막은 '못 쓸 수준'에서 '따라갈 만한 수준'이 됐지만, 정렬은 문단 단위이고 반 박자 늦는 순간은 남아 있습니다.
그래서 정직한 권고는 이렇습니다: AI 요약과 대본을 주 기능으로 쓰세요——그 둘은 견고합니다. 라이브 자막은 참고용으로. 이 부분은 계속 다듬어질 것입니다——이 기능에 preview 표시가 붙고, 기본값이 꺼짐이고, 본인 키를 쓰며, 설정에서 월 지출 한도부터 잡으라고 안내하는 이유가 바로 그것입니다.
자막이 있는 영상은 전혀 영향받지 않습니다——네이티브 자막 트랙이 언제나 우선이고, AI 전사는 정말 자막이 없는 영상에만 나섭니다.
1.4.0 릴리스 노트
- AI 전사(preview) 시간 정렬 재구축——모델의 앵커만 신뢰하고 분할과 페이스는 엔진이 관리. 자막이 쌓이거나 표류하지 않음
- 커버리지 구간별 검증·구멍 자동 재전사——전사 불가 구간은 정직하게 표시
- 대화 영상 분할 세분화——말하는 사람을 읽기가 따라감
- 신규 YOLO 모드(기본 꺼짐)——영상이 끝나면 같은 채널의 안 본 다음 영상을 자동 재생. 5초 카운트다운, 취소 가능. 무료 모델 병용 권장
- 레이아웃 2가지로 단순화——패널 오른쪽, 또는 전체 화면을 영상에
- 설정에 지출 한도 안내(바로가기 링크)와 전사 preview 고지 추가
- 수정: 영상 전환 시 이전 영상의 늦게 도착한 전사가 현재 화면을 덮어쓰지 않음
DeepSRT는 Mac App Store에서 한 번 구매로 이용합니다. AI 전사에는 본인의 Gemini API 키가 필요합니다. 1.4.0은 현재 심사 중.