1.3.0 が公開されたその夜、実世界の動画で徹底的に試しました——金融チャンネルの週末総括、複数人が語る心霊ポッドキャスト、マレーシアの心霊スポット実録。AI 文字起こしは 1.3.0 の目玉機能です:字幕トラックのない動画では、DeepSRT が Gemini に動画そのものを「観て」もらい、ライブ字幕・文字起こし・要約がそのまま動きます。
テキストはほぼ毎回正しい。時間は、ほぼ毎回わが道を行く。
モデルは聞き取れる、でも拍子が取れない
最初の動画は、ちょうど 60 秒ずつの字幕 16 本で返ってきました——1 分ぶんの台本が壁のように画面に積み上がる。細かく切るよう頼むと、素直に 181 本の美しい小さな字幕をくれました。ただしタイムラインはどんどん漂流:中盤で数十秒遅れ、最後の字幕は 4,181 秒に着地——動画の全長は 858 秒です。
これは我々のプロンプトの書き方の問題ではありません。コミュニティ全体が記録してきた Gemini の限界です:SRT 級の正確なタイムスタンプは生成できず、しかも粒度と正確さはトレードオフ——細かく切らせるほど、漂流で支払うことになる。
公平に言えば、Google の公式ドキュメントは字幕級の時間精度を約束したことは一度もありません。能力一覧にあるのは「記述、分割、情報抽出、特定タイムスタンプへの参照」——タイムスタンプを参照することと、ミリ秒の SRT を生成することは別の仕事です。YouTube URL 入力自体もまだ preview(無料、1 日 8 時間まで、ルールは変更されうる)。公式が preview と記す地盤の上に、時間精度を要する機能を建てているわけです——下の表のどのプロジェクトも、同じ壁の前で進路を変えた理由がそれです。
| 公式ドキュメントの記述 | DeepSRT にとっての意味 | |
|---|---|---|
| Preview | 「The YouTube URL feature is in preview and is available at no charge. Pricing and rate limits are likely to change.」 | 我々の preview 表記は保守的なのではない——上流そのものが未確定 |
| 上限 | 無料枠は 1 日あたり YouTube 動画 8 時間まで、公開動画のみ | 毎日の割り当ての公式な出どころ |
| コスト | 動画は 1 FPS でサンプリング。低解像度で約 100 トークン/秒(デフォルト 300) | 我々の実測は約 91 トークン/秒で公式値と一致——「リクエストごとに動画全体を再取り込みする」コストの根拠 |
| 能力 | 能力一覧の記述:describe、segment、extract information、特定タイムスタンプへの参照 | 字幕級の時間精度は一度も約束されていない——タイムスタンプの参照とミリ秒 SRT の生成は別の仕事 |
ほかのプロジェクトはどうしたか
修正に取りかかる前にコミュニティを調べました。この壁にぶつかったのは我々だけではなく、どのプロジェクトも最終的に何らかの「諦め」を選んでいました:
| プロジェクト | ぶつかった壁 | 下した決断 |
|---|---|---|
| pyVideoTrans | Gemini は SRT 級の正確なタイムスタンプを生成できない。バッチ処理ではフォーマットを忘れ、勝手に再分割することも | Gemini に時間を求めるのをやめた。音声をダウンロードし、VAD でミリ秒精度の切り出し。Gemini はテキストのみ |
| yt-whisper 系 | 正確なタイムラインが必要 | マルチモーダルモデルの道を捨てた。音声をダウンロードして Whisper に丸ごと任せる |
| video-intel | 分割転写でタイムスタンプがチャンク間でずれ、時間の桁が欠落し、内容が静かに抜け落ちる。強いモデルに替えたら悪化 | ライブ級の精度を諦めた。翻訳・検索用のオフライン転写に徹し、分割・正規化・カバレッジ検査で多層防御 |
| gemini-transcribe | 細かいタイムスタンプが信頼できない | 細かさを諦めた。「論理的にグループ化されたタイムスタンプ」を掲げる——読むためのもので、プレーヤーの同期用ではない |
パターンが見えるでしょうか:音声を取れる者は VAD と Whisper へ逃げ、取れない者は正確な時間を諦めた。我々にはどちらの道もありません——DeepSRT は動画をダウンロードしない。それは製品の約束であり、この機能が存在する前提でもある。それでいてライブ字幕は時間が合っていなければならない。公開情報に成功例のないことに挑んでいるのです。
我々の決断:アンカーだけを信じ、スパンは信じない
計測を重ねると規則が浮かびました:モデルが「この文は何分何秒に始まる」と言うときは概ね信用できる。「どれだけ続いたか」は、しばしば創作です。
どれほどか?ある 33 分の動画で、モデルは 22 文字の字幕 1 本が 2,723 秒にわたると主張しました。別の回では「全編を隙間なくカバー」する回答——ただし文字数を時間で割ると毎秒 0.3 文字。話し言葉の中国語は毎秒 3〜6 文字です。線香より遅く話す人間はいません。
そこで 1.4.0 の字幕エンジンは、信頼の境界線をここに引きました:
- アンカーは使う。字幕の開始はモデルのタイムスタンプに従う——独立した抜き取り検証で、粗い回答のアンカーは秒レベルで正確だと確認済み。
- スパンは自前で計算。長すぎる字幕は句読点で分割し、文字数に比例して時間を配る——補間誤差には上限があり(最大でも字幕 1 本ぶん)、モデル自身の分割による漂流は際限なく累積する。
- 物理を審判に。主張されたスパンがあり得ない話速を意味するなら、その時間は虚構。
穴のほうが、当て推量よりまし
いちばん難しい教訓は例の心霊動画から。長い B ロール、環境音、途切れがちな会話——モデルは数分間に散らばった発話を1 本の字幕に詰め込みました。テキストをアンカーに押し戻せば誤り(6 分後に話される言葉が画面に出る)、スパン全体に引き延ばしても誤り(どの行も 20 秒張り付く)。どちらも当て推量です。
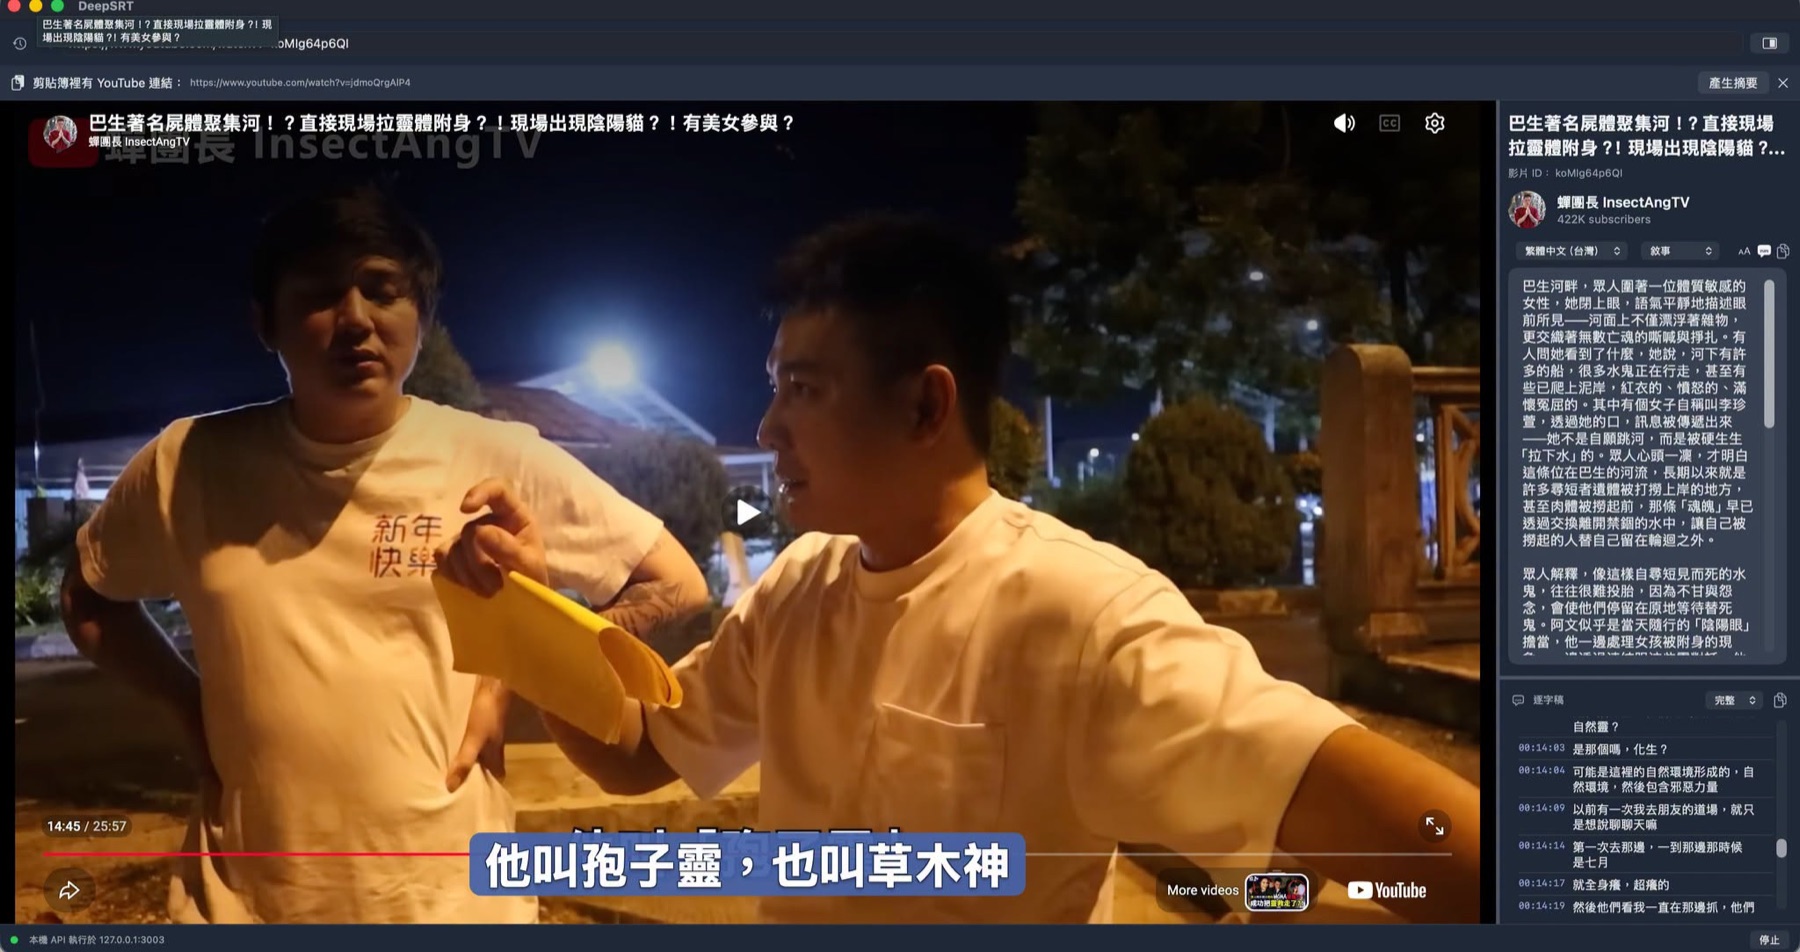
だから推量しません:詰め込まれた字幕は捨て、その時間は穴にする。エンジンは区間ごとにカバレッジを検査し、欠けた範囲だけを再転写——範囲を絞った問いには、時間の正しい範囲の答えが返ってきやすい。それでも埋まらない部分は、画面上で正直に「この数分は転写できませんでした」と示します。
叫び声、雑踏、音楽だけの区間には、そもそも転写できる発話がありません。空白は故障ではない——あるふりをすることが故障です。
正直に:まだ完璧ではありません
先ほどの表をもう一度見てください——各プロジェクトが「正確な時間」の前で次々と進路を変えたのは、努力不足ではなく、URL しかない制約下ではまだ完全な解がないからです。我々のやり方でライブ字幕は「使いものにならない」から「ついていける」へ進みましたが、位置合わせは段落レベルで、半拍遅れる瞬間は残ります。
正直なおすすめはこうです:AI 要約と文字起こしを主役として使ってください——そこは堅実です。ライブ字幕は参考程度に。この部分は磨き込みを続けます——preview と記され、デフォルトでオフ、自分のキーを使い、設定画面で月間支出上限の設定を促しているのは、まさにそのためです。
字幕のある動画には一切影響しません——ネイティブの字幕トラックが常に優先で、AI 転写は本当に字幕がない動画にだけ出動します。
1.4.0 リリースノート
- AI 文字起こし(preview)の時間合わせを再構築——モデルのアンカーだけを信頼し、分割とテンポはエンジンが掌握。字幕の積み上がりと漂流を解消
- カバレッジを区間ごとに検証し、穴を自動再転写——転写できない区間は正直に表示、静かな空白のまま出荷しない
- 会話動画の分割を細かく——話す人に読みが追いつく
- 新機能 YOLO モード(デフォルトはオフ)——動画が終わると同じチャンネルの未視聴動画を自動再生。5 秒カウントダウンでキャンセル可。無料モデルとの併用推奨
- レイアウトを 2 状態に簡素化——パネルを右側に、または全画面を動画に
- 設定に支出上限のリマインダー(直リンク付き)と転写の preview 注記を追加
- 修正:動画切り替え時、前の動画の遅れて届いた転写が現在の画面を上書きしない
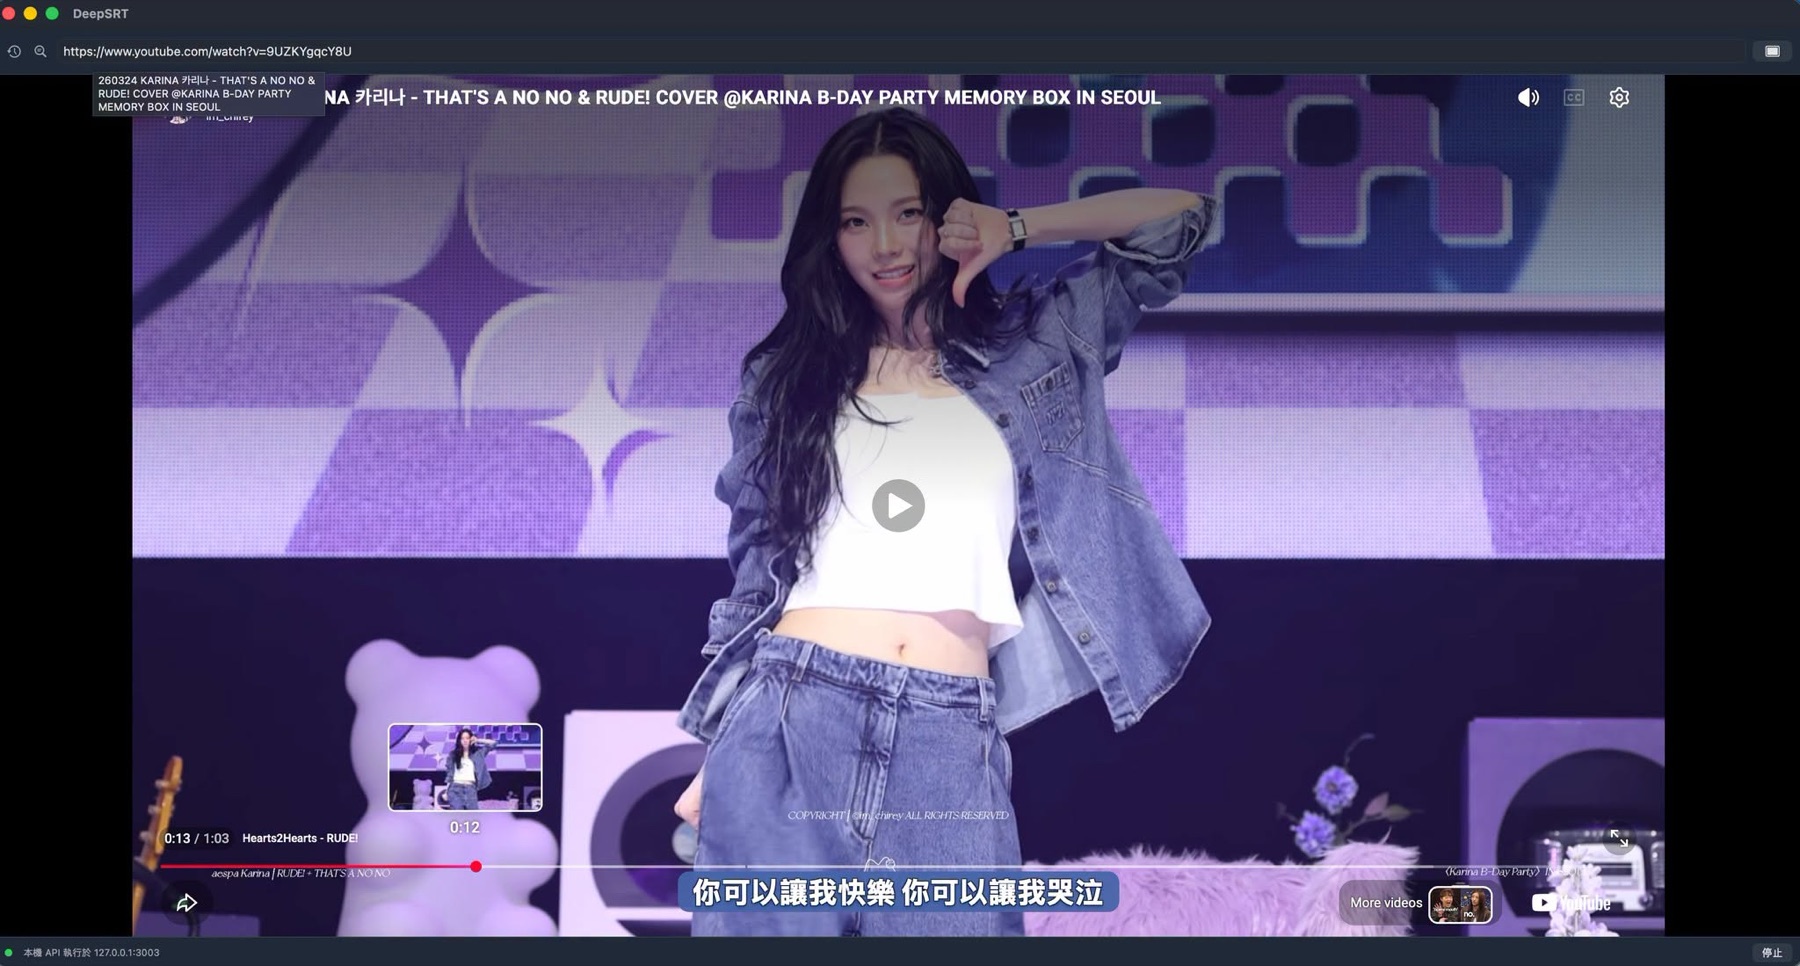
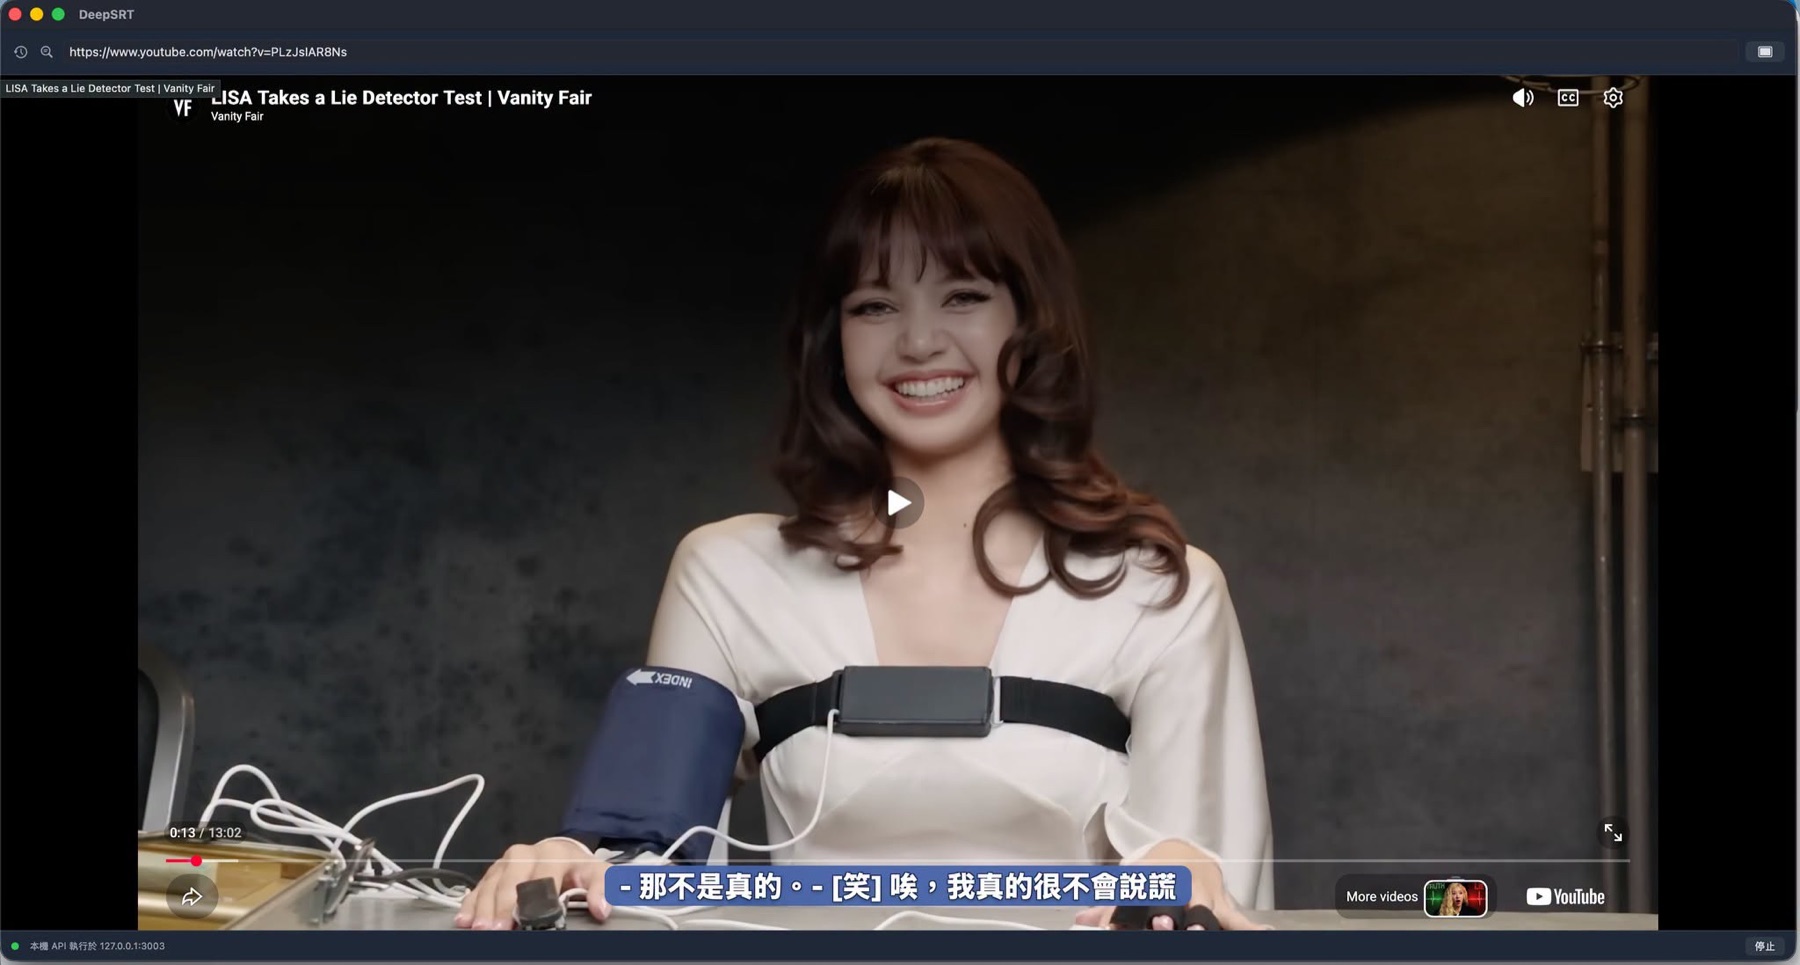
DeepSRT は買い切りで Mac App Store にて公開中。AI 文字起こしにはご自身の Gemini API キーが必要です。1.4.0 は現在審査中。