1.3.0 上架那天晚上,我們拿真實世界的影片來虐它——財經頻道的週末點評、多人對談的靈異 podcast、大馬外景的探靈實錄。AI 逐字稿是 1.3.0 的主打功能:影片沒有字幕軌,DeepSRT 就請 Gemini 直接「看」影片,即時字幕、逐字稿、摘要照常運作。
文字幾乎每次都是對的。時間,幾乎每次都有自己的想法。
模型聽得懂,但抓不準拍子
第一支影片回來 16 條字幕,每條剛好 60 秒——一整分鐘的講稿疊成一面牆掛在畫面上。我們要求它切細一點,它從善如流地給了 181 條漂亮的小字幕,然後時間軸一路漂移:中段慢了幾十秒,最後一條落在 4181 秒——影片全長只有 858 秒。
這不是我們的 prompt 寫壞了。這是整個社群都記錄過的 Gemini 限制:它無法產生 SRT 等級的精確時間戳,而且粒度和準度是互相交換的——逼它切細,它就漂給你看。
公平地說,Google 的官方文件從來沒有承諾過字幕級的時間精度——能力清單寫的是「描述、切分、擷取資訊、參照特定時間戳」,而「參照時間戳」和「產生毫秒級的 SRT」是兩件事。YouTube URL 輸入本身也還在 preview(免費、每天 8 小時額度、規則隨時可能變)。我們是在一個官方都還標著 preview 的地基上,蓋一個需要對時精度的功能——這就是為什麼下面這張表裡,每個專案都在同一面牆前轉了向。
| 官方怎麼說 | 對 DeepSRT 的意義 | |
|---|---|---|
| Preview | 「The YouTube URL feature is in preview and is available at no charge. Pricing and rate limits are likely to change.」 | 我們把功能標成 preview 不是保守——上游本身就還沒定案 |
| 額度 | 免費層每天最多 8 小時 YouTube 影片,僅限公開影片 | 你的每日額度,官方出處在此 |
| 成本 | 影片以 1 FPS 取樣;低解析度約 100 tokens/秒(預設 300) | 我們實測約 91 tokens/秒,與官方數字吻合——也是「每次請求都重新攝取整支影片」的成本由來 |
| 能力 | 能力清單:describe、segment、extract information、refer to specific timestamps | 官方從未承諾字幕級時間精度——「參照時間戳」和「產生毫秒級 SRT」是兩回事 |
別人怎麼處理
動手修之前我們先查了社群——遇到這面牆的不只我們,而且每一家最後都選擇了某種形式的放棄:
| 專案 | 遇到的阻礙 | 他們的決定 |
|---|---|---|
| pyVideoTrans | Gemini 無法產生 SRT 等級的精確時間戳;批次任務還會忘記格式、亂切段落 | 放棄向 Gemini 要時間。下載音訊,用 VAD 做毫秒級切段,Gemini 只負責文字 |
| yt-whisper 系列 | 需要精確時間軸 | 放棄多模態模型這條路。下載音訊,整包交給 Whisper |
| video-intel | 分塊轉錄時間戳跨塊錯位、小時位遺失、內容靜默缺漏;換更強的模型反而更糟 | 放棄即時等級的精度。做離線逐字稿供翻譯與檢索,靠分塊、正規化、涵蓋率檢查層層防禦 |
| gemini-transcribe | 細粒度時間戳不可靠 | 放棄細粒度。標榜「邏輯分組的時間戳」——給人讀的,不是給播放器對時的 |
看出模式了嗎:拿得到音訊的,都逃去找 VAD 和 Whisper;拿不到的,都放棄了精確時間。而我們兩條路都不通——DeepSRT 不下載影片,這是產品承諾,也是這個功能存在的前提;但即時字幕又必須對時。我們是在做一件公開資料裡找不到成功先例的事。
我們的決定:只信錨點,不信時長
反覆量測之後,規律浮現了:模型說「這句話從幾分幾秒開始」大致可信,說「這句話講了多久」經常是編的。
有多離譜?某支 33 分鐘的影片,模型宣稱一條 22 個字的字幕橫跨 2,723 秒。另一輪它給了「無縫覆蓋全片」的答案——但把字數除以時長,語速是每秒 0.3 個字。中文口語每秒三到六個字。沒有人講話講得比一炷香還慢。
所以 1.4.0 的字幕引擎把信任邊界劃在這裡:
- 錨點拿來用。字幕起點跟著模型的時間戳走——我們用獨立抽查驗證過,粗粒度回答的錨點能準到秒級。
- 時長自己算。太長的字幕在標點處切開,時間按字數比例鋪排——內插誤差有上界(最多錯在一條字幕內),模型自切的漂移是累積無上界的。
- 物理當裁判。聲稱的時長若意味著不可能的語速,那段時間就是虛構的。
寧可留洞,不可瞎猜
最難的一課來自那支探靈影片。大量空景、環境音、間歇的對白——模型把散落在幾分鐘裡的零星對話打包成一條字幕。這種時候把文字擠回錨點是錯的(畫面上出現六分鐘後才會說的話),攤開來也是錯的(每句話糊在螢幕上二十秒)。兩種都是瞎猜。
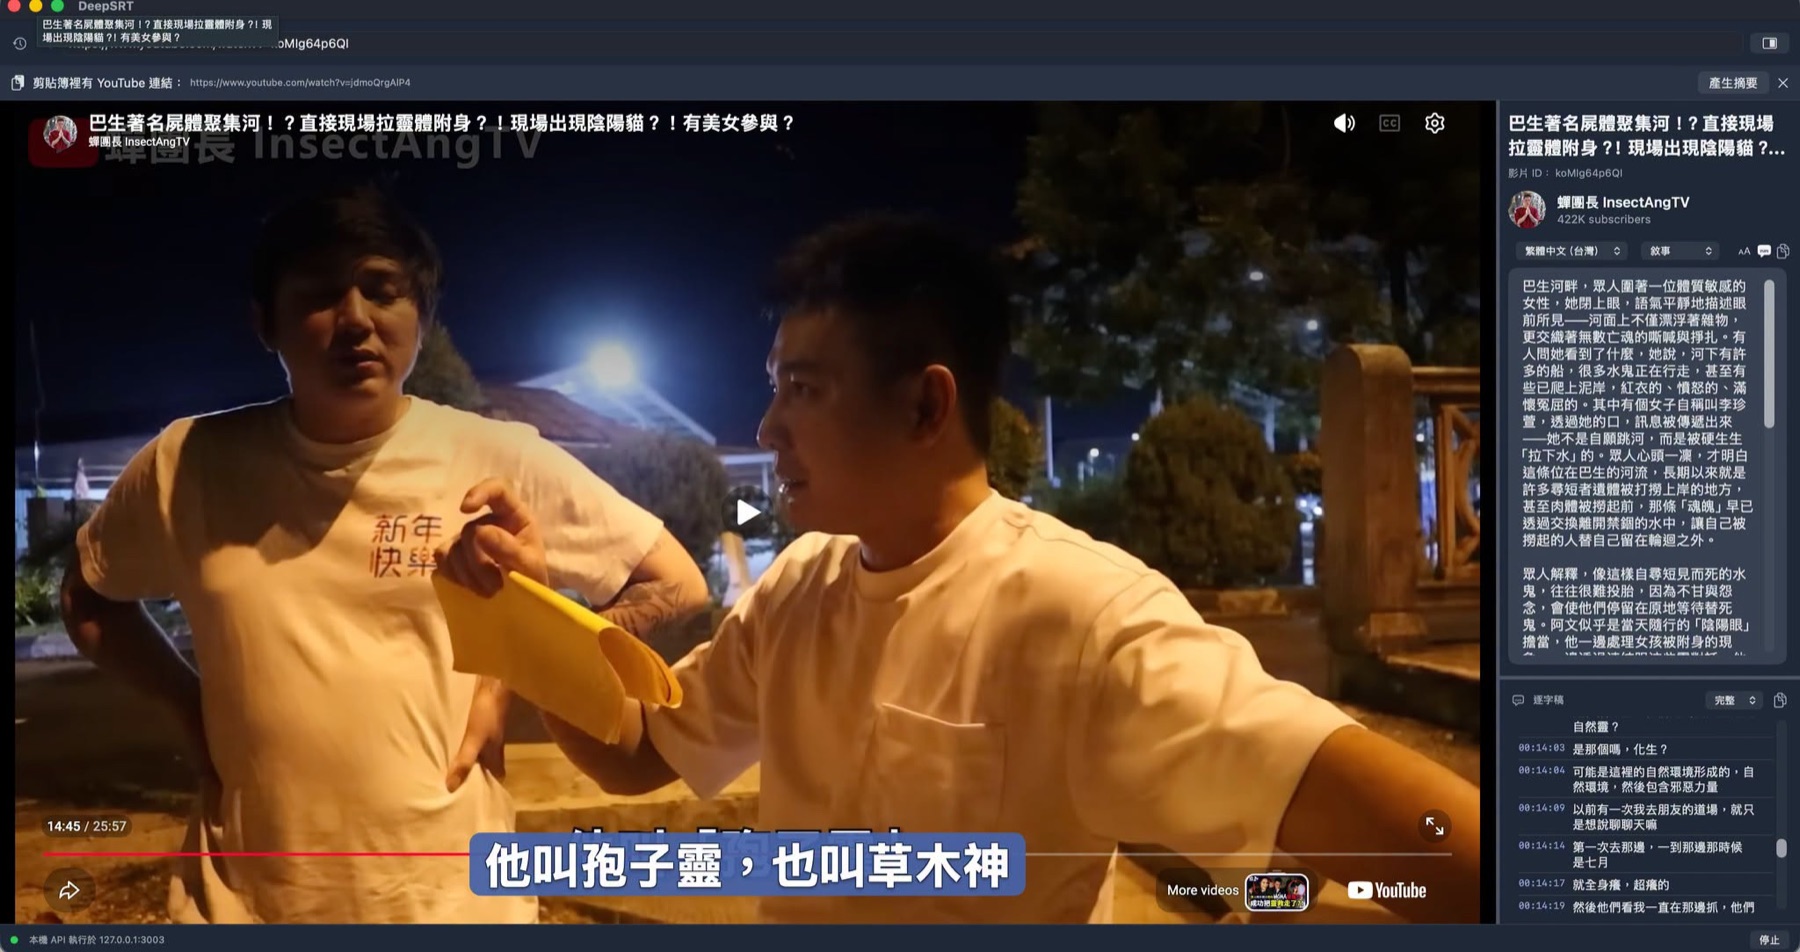
所以我們不猜:打包的字幕直接丟掉,讓那段時間變成一個洞。引擎逐段檢查涵蓋率,發現洞就針對那個範圍重新轉錄——範圍問題通常會得到範圍答案,時間反而是準的。補不起來的,畫面上誠實告訴你「這幾分鐘轉不出來」。
尖叫、人群、純音樂的段落本來就沒有可轉錄的話語。空白不是故障——假裝有才是。
說實話:這還不完美
上面那張表值得再看一眼——各家專案紛紛在「精確時間」面前轉向,不是他們不夠努力,是這個問題在只有 URL 的約束下還沒有完美解。我們的做法讓字幕從「不可用」進步到「跟得上」,但時間對位是段落級的,偶爾還是會有慢半拍的瞬間。
所以我們的誠實建議:把 AI 摘要和逐字稿當主要功能用——那兩個是可靠的;即時字幕當參考。這部分還需要更多打磨,而它會持續打磨下去——這正是這個功能標著 preview、預設關閉、用你自己的 key、並且我們提醒你先設好每月支出上限的原因。
有字幕的影片完全不受影響——原生字幕軌永遠優先,AI 轉錄只在影片真的沒有字幕時出手。
1.4.0 release notes
- AI 逐字稿(preview)時間對位重做——只信任模型的錨點,切分與節奏由引擎掌握,字幕不再堆疊或漂移
- 涵蓋率逐段驗證、自動補洞——轉不出來的段落誠實標示,不再默默留白
- 對談影片切分更細——讀起來跟得上說話的人
- 新增 YOLO 模式(預設關閉)——影片播完自動接播同頻道下一支沒看過的,倒數 5 秒可取消,建議搭配免費模型
- 佈局簡化為兩種——面板在右側,或整個畫面留給影片
- 設定頁新增支出上限提醒(附直達連結)與轉錄 preview 警語
- 修正:切換影片時,前一支影片遲到的轉錄結果不再覆蓋目前畫面
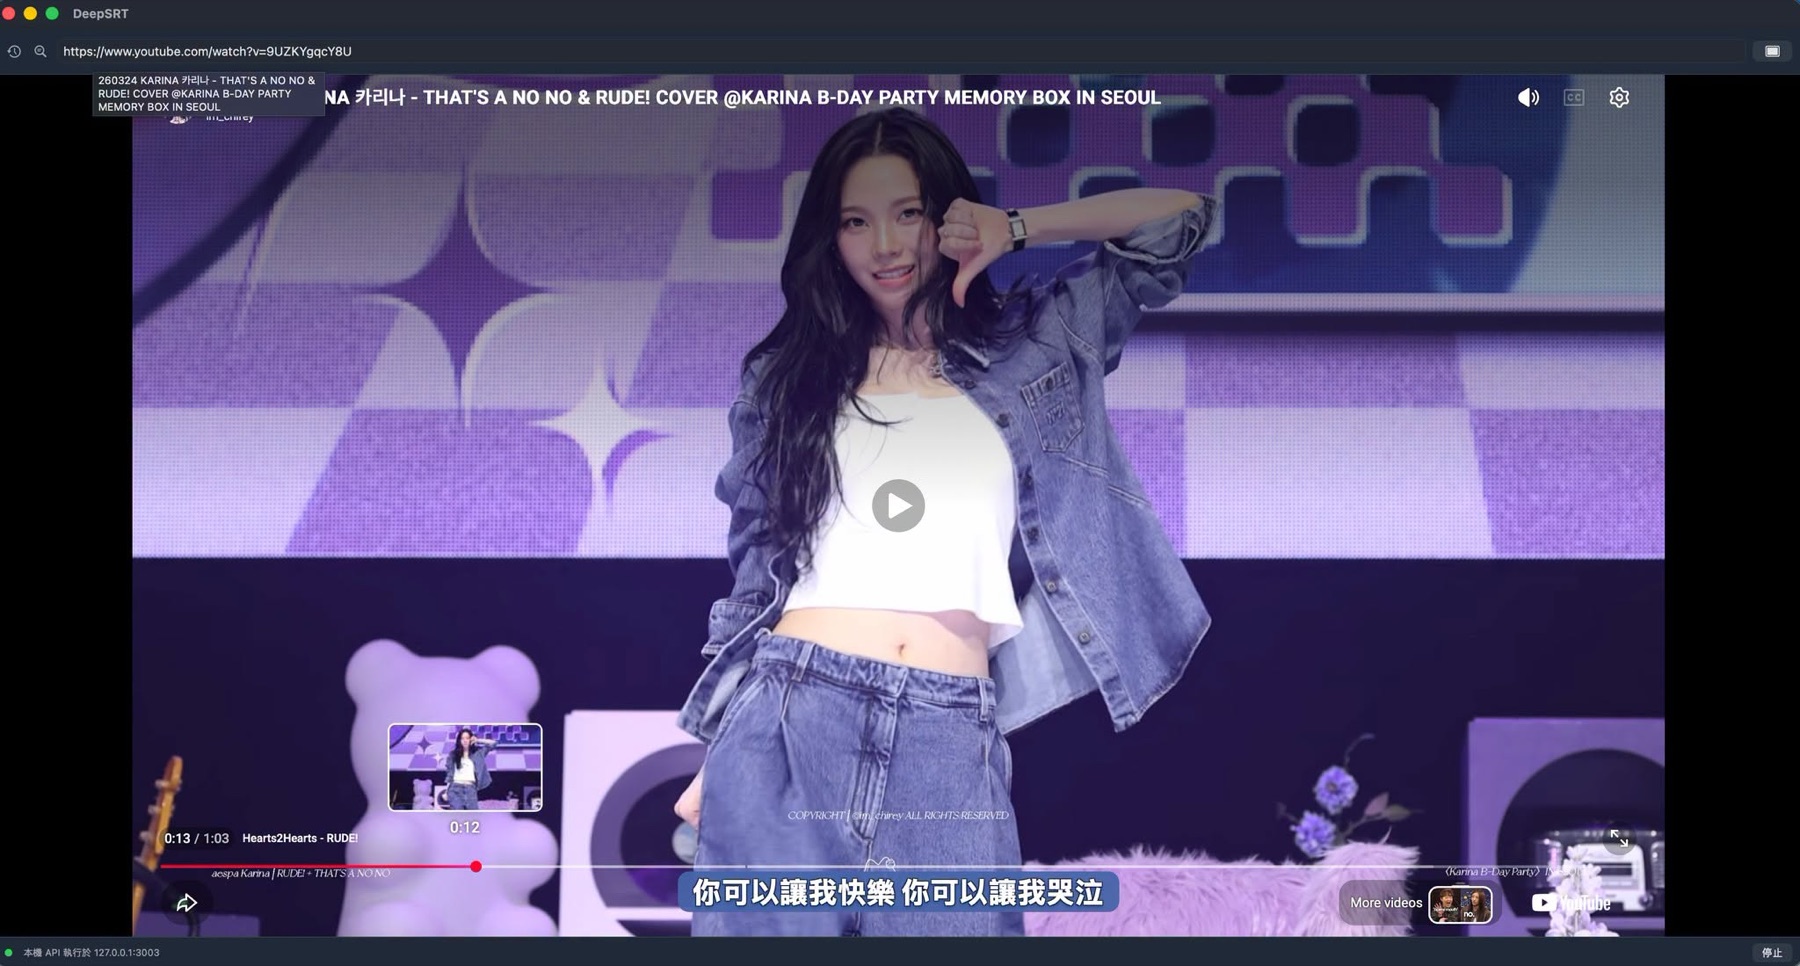
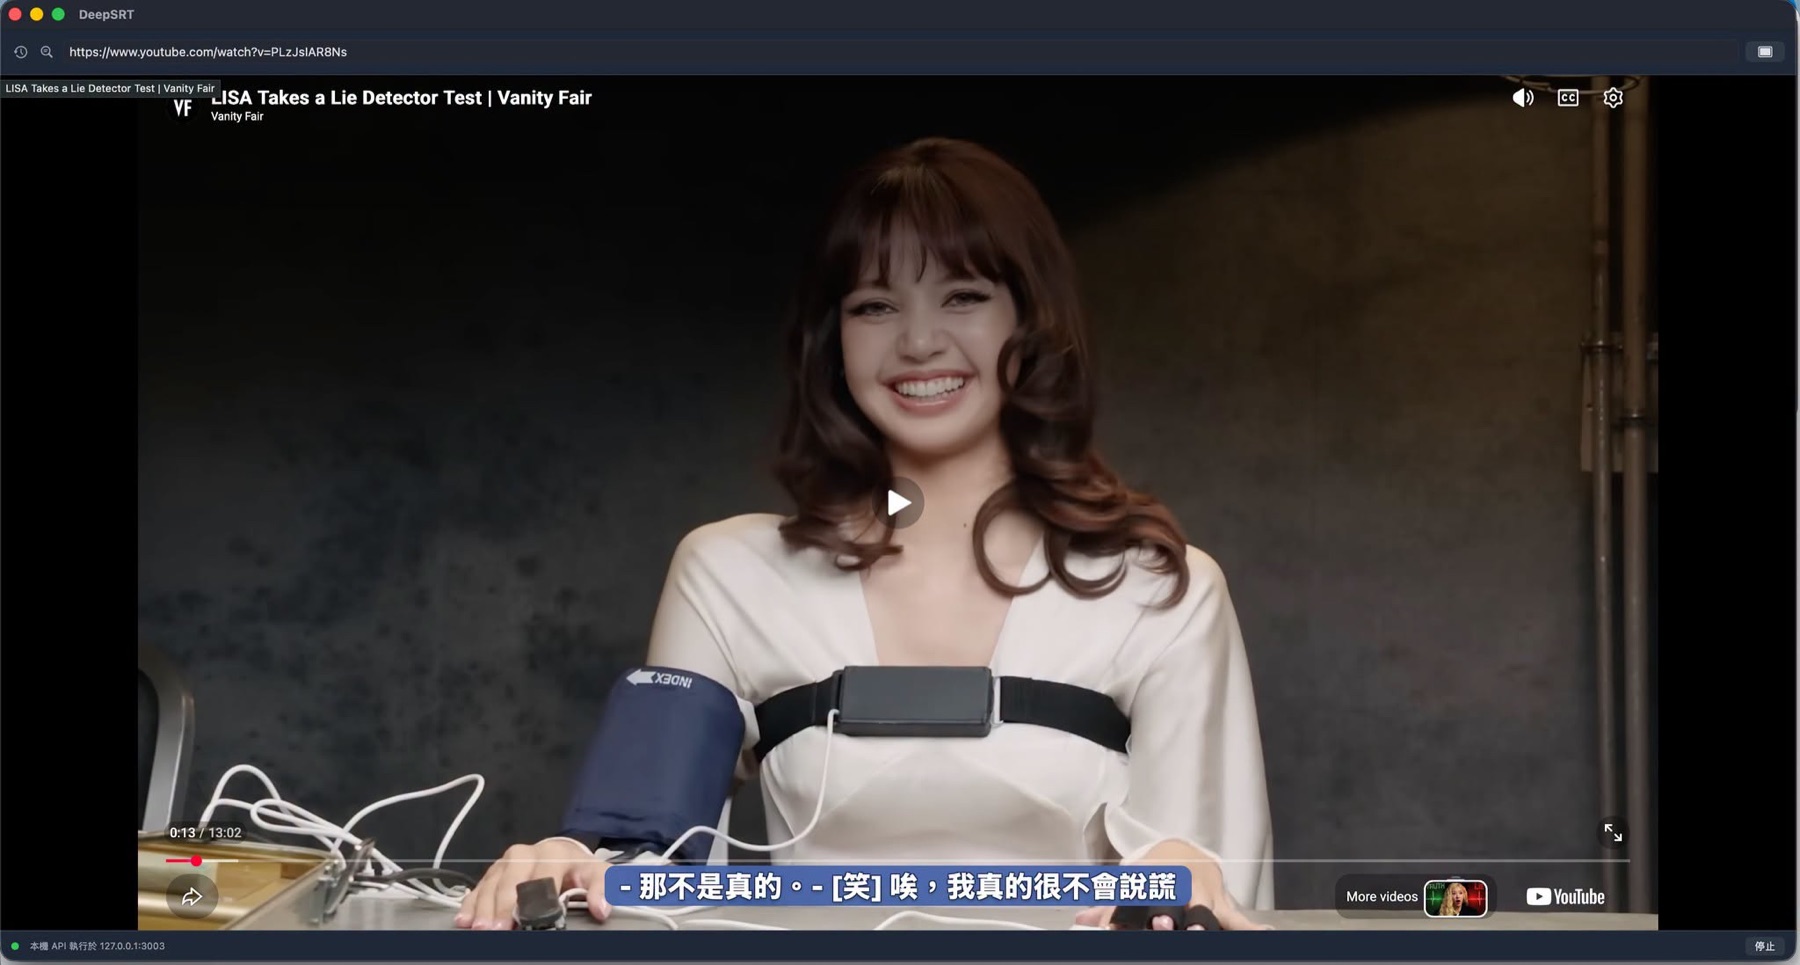
DeepSRT 買斷制,在 Mac App Store 上架中。AI 逐字稿需要你自己的 Gemini API key。1.4.0 現正審核中。